Esta es una versión breve de mi presentación en el XVII Congreso Nacional de Mastozoología (Monterrey, NL, Octubre de 2026) sobre ‘Herramientas de código abierto para conectar las colecciones mastozoológicas y sus datos con la macroecología’. En resumen, una gran parte de los datos de distribución y fenotipos que provienen de colecciones científicas sigue inaccesible digitalmente, y hay un cuello de botella técnico entre ejemplares, sus datos, y su integración en análisis macroecológicos. Por suerte ya hay más herramientas para resolverlo y corren en las compus que ya tenemos.
De CSV a Parquet
Como primer ejemplo usé una descarga de GBIF con casi 4 millones de registros de roedores (2.1 GB en CSV). Convertirla a Parquet con arrow se hace una sola vez, me tomó ~104 segundos y hacer esto reduce el archivo a 283 MB (7× menos espacio) y deja los datos listos para consultas eficientes. Es solamente cuestión de usar otro formato (libre y abierto) para guardar y compartir datos.
library(arrow)

csv_ds <- open_dataset(
  "data/0129482-230530130749713.csv",
  format = "text",
  schema = schema(.default = string()), # todo como texto
  parse_options = csv_parse_options(delimiter = "\t", quoting = FALSE)
)
write_dataset(csv_ds, "data/gbif_mammals.parquet", format = "parquet")
Consultar sin cargar todo en memoria
En formato Parquet, leer los 3.96 millones de registros me toma 19.5 segundos con read_parquet() (vs. ~8 min con read.delim()), y las consultas filtradas solo traen a memoria lo necesario:
mx <- open_dataset("data/gbif_mammals.parquet") |>
  dplyr::filter(countryCode == "MX") |>
  dplyr::collect()
Operaciones de conteo, promedios y operaciones por grupos toman ~2 segundos cada una, porque solo se trabaja con la columna necesaria y no con todo a la vez. Al preparar la presentación me sorprendió que Países Bajos tuvo más de un millón de registros, pero revisando los datos resulta que la mayoría viene de campañas de control de fauna invasora (rata almizclera y coipo). En este caso el número de registros ≠ diversidad/abundancia y una consulta de 2 segundos nos puede evitar conclusiones incorrectas.
Mapas con millones de puntos
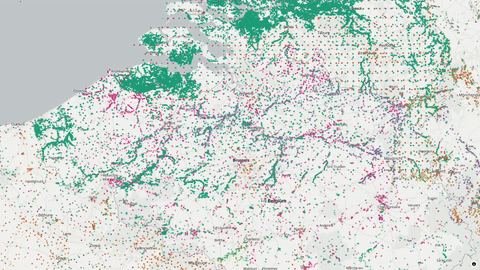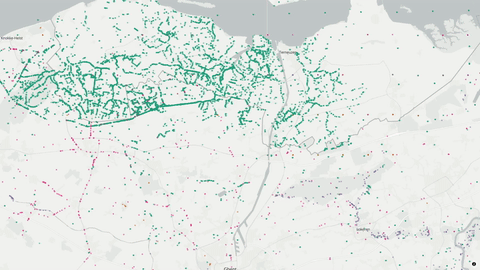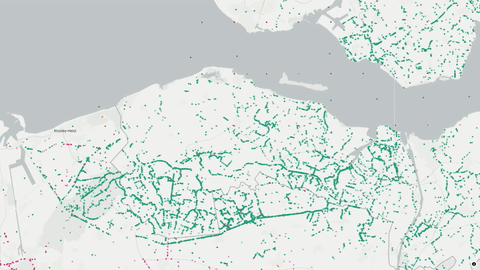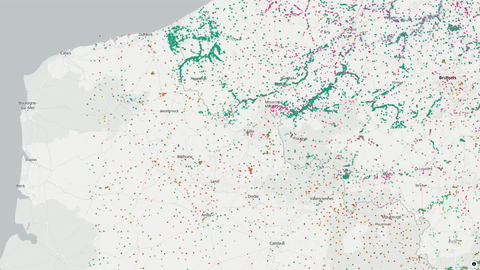
Con freestiler convertí 1.68 millones de puntos de roedores acotados a Europa central a un solo archivo PMTiles de 79 MB que puedo ver interactivamente con mapgl y MapLibre. Es como cuando usamos Google Maps en el teléfono. Lo que no estamos viendo no está en memoria. El proceso solo se hace una vez y se puede especificar para qué niveles de zoom armar el mosaico.
Operaciones espaciales con duckspatial
Para distribuciones geográficas de aves (Birds of the World 2025, un GeoPackage de 8.7 GB con 17,377 geometrías de unas 11 mil especies), ni puedo cargar todo como objeto sf. Con duckspatial podemos hacer operaciones espaciales que ocurren en DuckDB y solo llegan a R los resultados:
library(duckspatial)

con <- ddbs_create_conn(dbdir = "memory")
botw <- ddbs_open_dataset("BOTW_2025.gpkg", conn = con)
ddbs_write_table(con, mexico_sf, "mexico")

botw_mx <- ddbs_filter(botw, "mexico", predicate = "intersects", conn = con) |>
  ddbs_collect(as = "sf")
Me tomó 2.5 minutos hacer la intersección para quedarme con las especies presentes en México (1,679 de 17,377 geometrías), y también se pueden hacer filtros no espaciales (especies al azar, familias, etc.) sin involucarar a las geometrías.
Datos estructurados desde PDFs con ellmer
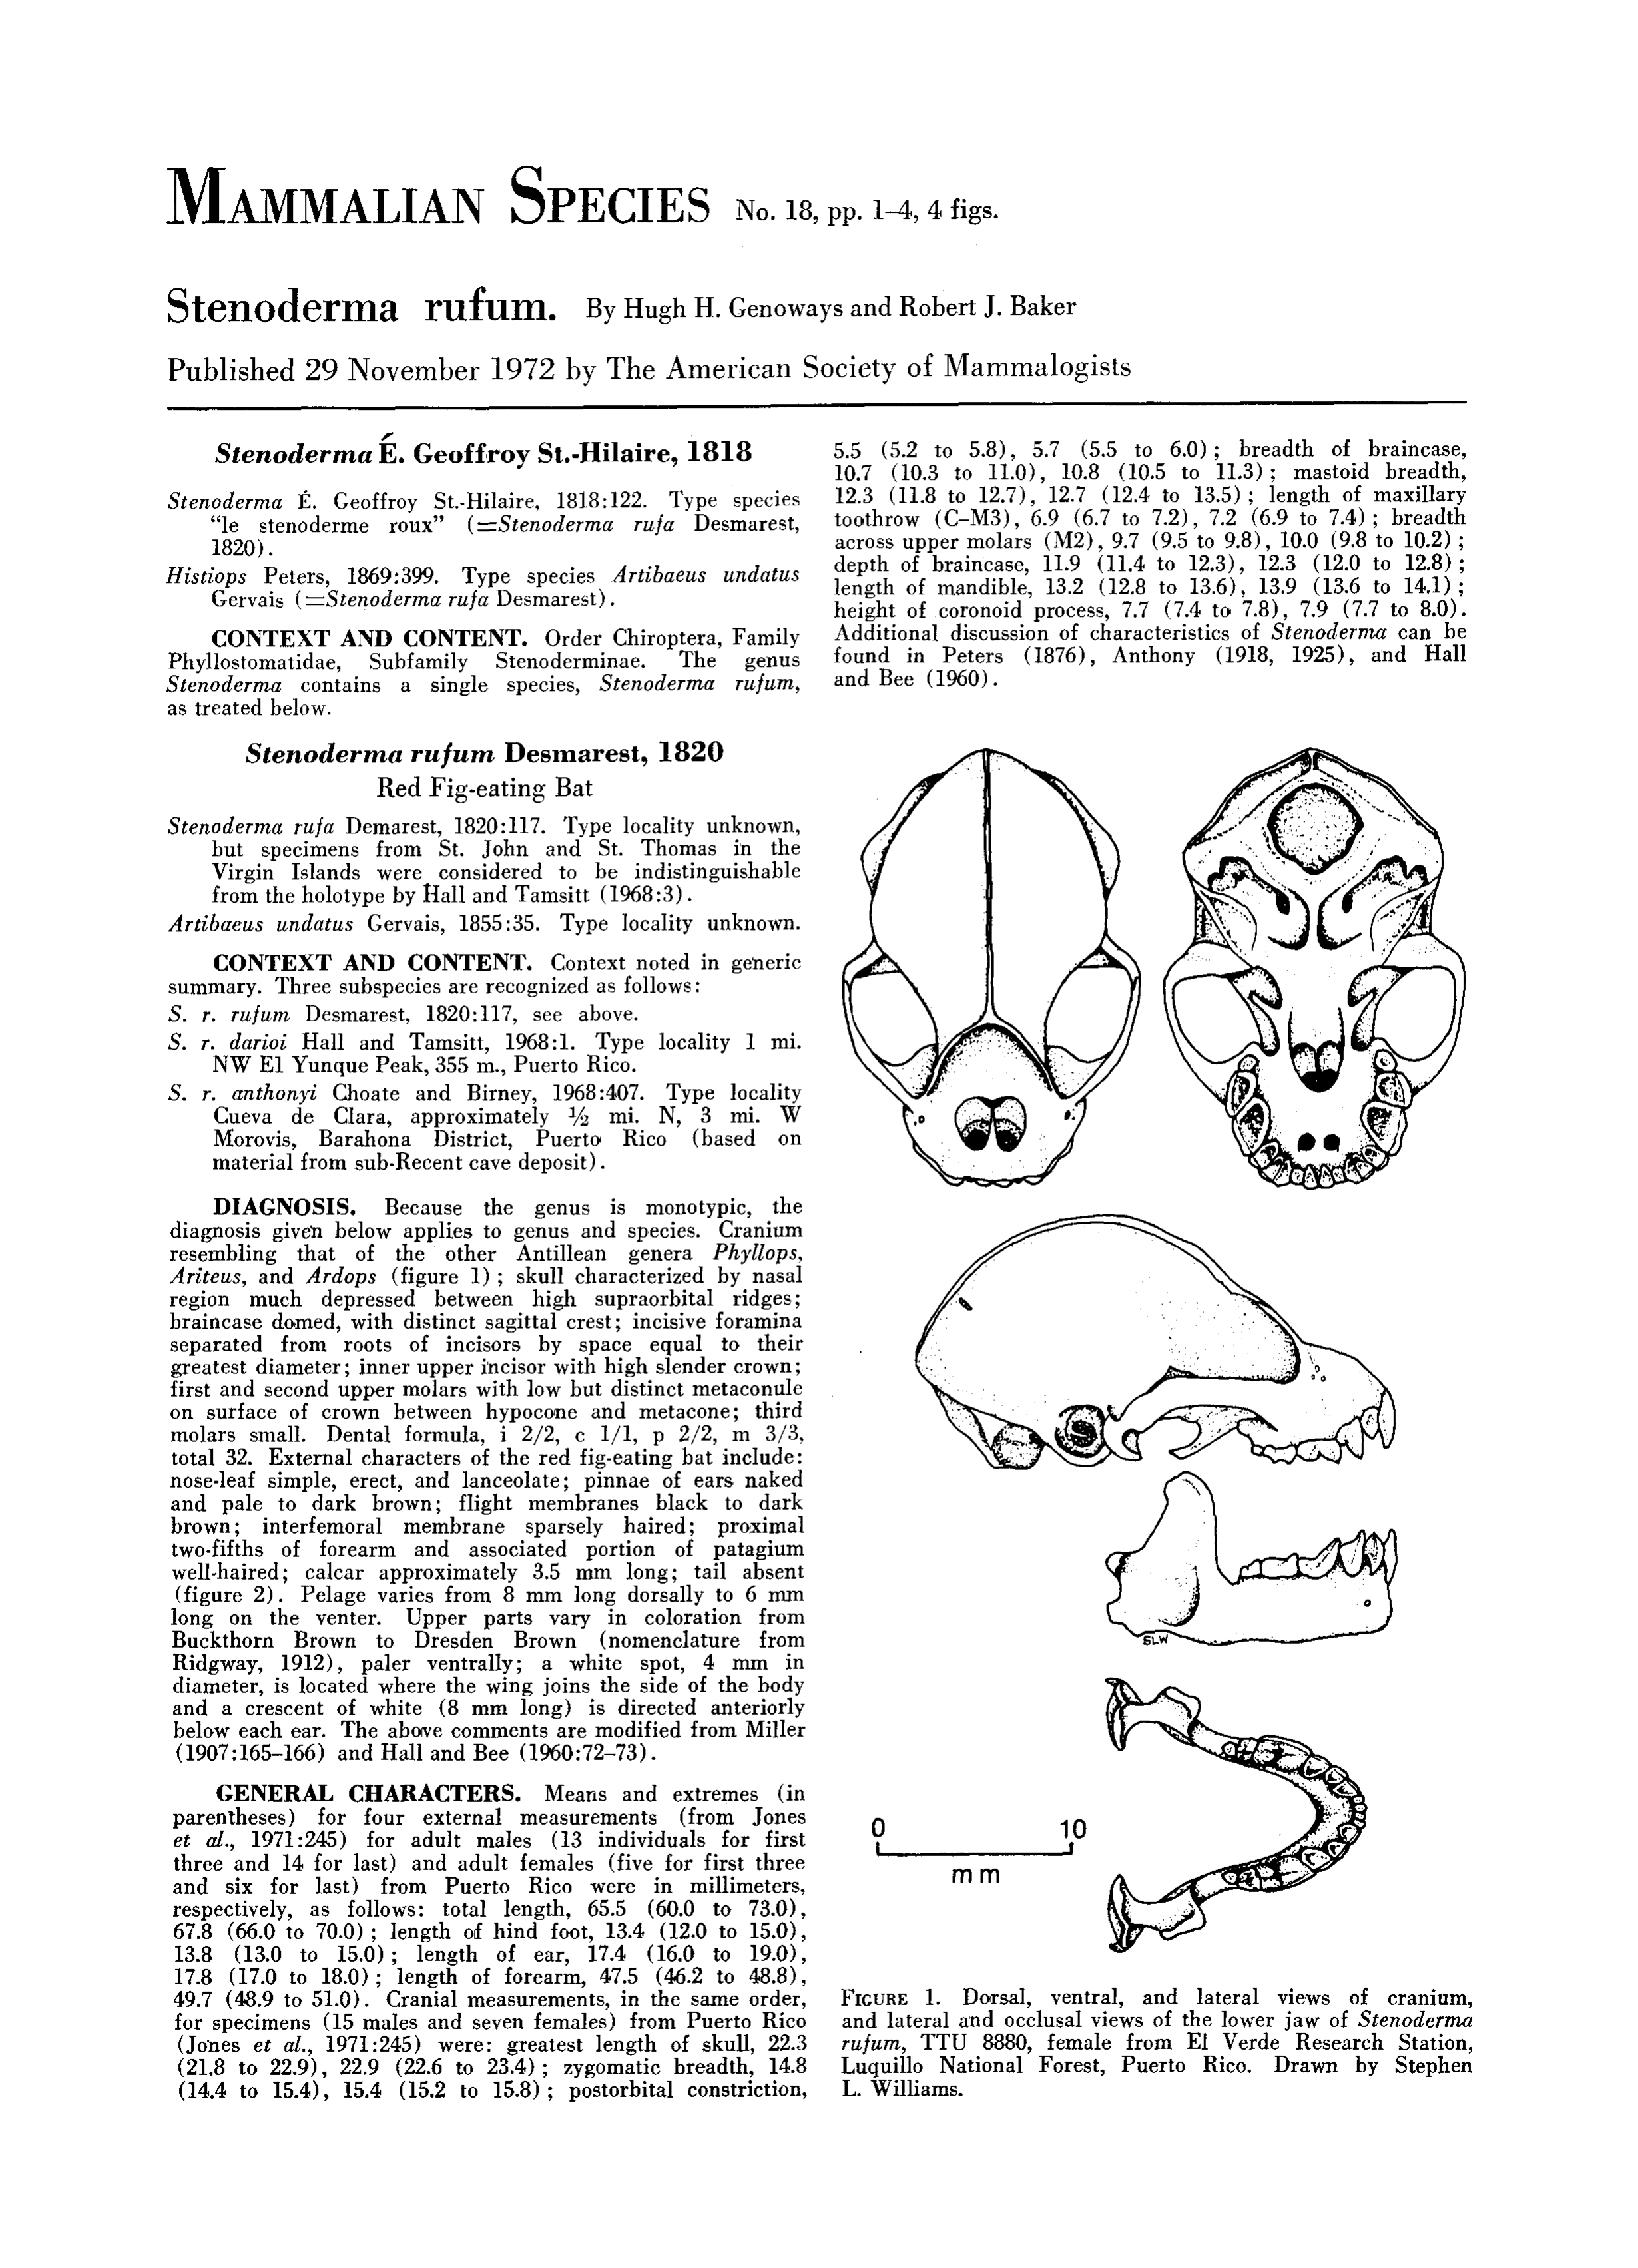
Muchos rasgos morfológicos solo existen en fichas y monografías escaneadas como imagen. Con ellmer se pueden extraer valores de rasgos desde PDFs (sin OCR) como datos estructurados, con un esquema (type_object) que garantiza una salida JSON válida y sin valores inventados:
library(ellmer)
chatpdfs <- chat_openai(
  model = "gpt-6-luna",
  system_prompt = "extract data from scientific papers"
)
mybatfile <- content_pdf_file("data/PDF/stenoderma.pdf")
of_interest <- type_object(
  scientific_name = type_string("focal species of the document"),
  forearm_length_M = type_number("forearm length (mm), males"),
  forearm_length_F = type_number("forearm length (mm), females"),
  ear_length = type_number("ear length (mm)"))

bat_info <- chatpdfs$chat_structured(
  "extract the trait values", mybatfile, type = of_interest
)
La extracción tarda unos segundos por documento y cuesta ~0.002 USD por PDF usando mi clave de API de OpenAI, así que esta proceso se puede escalar a cientos de fichas en lote sin gastar tanto. Ojo que sigue siendo necesario
Conclusiones
Nuevas herramientas (DuckDB, Arrow, Parquet, PMTiles, modelos de visión) democratizan el trabajo con “Big Data” de biodiversidad. SOn de bajo costo y nos permiten trabajar de manera escalable, reproducible e interoperable. Podemos modernizar los flujos de trabajo de las colecciones y los análisis macroecológicos sin gaster tanto en infraestructura nueva. Los retos más bien son otros como difusión y adopción de las herramientas, incentivos para liberar y estandarizar datos, y hacer uso ético y responsable de IA.
PDF de mi presentación aquí